
AI-reputatie: wat zeggen AI-engines over Belgische supermarkten?


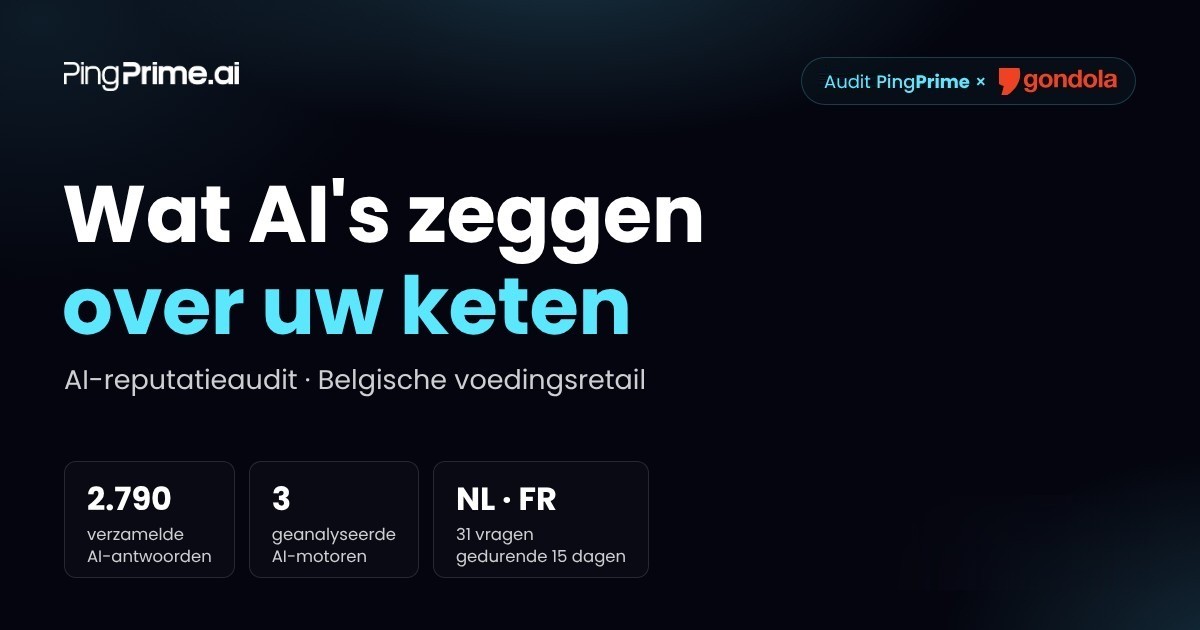
In het kort. Voor Gondola, hét vakmedium van de Belgische retail en FMCG, onderzocht PingPrime hoe AI-engines over Belgische supermarkten spreken: 31 consumentenvragen, elke dag gesteld van 25 september tot 9 oktober 2026 aan ChatGPT, Google AI Overview en Google AI Mode, in het Frans en het Nederlands. 2.790 AI-antwoorden, 15.368 geciteerde links. Wat ze tonen: Delhaize domineert het gesprek, maar concentreert de meest terugkerende en samenhangende kritiek van de sector; Colruyt is de kampioen van de aanbeveling, maar sommige productverdicten ontsnappen haar; Bio-Planet, drie keer minder zichtbaar dan de leiders, haalt meer aanbevelingen dan Carrefour. En niets staat stil: één AI-lezing op vijf veranderde van positie in 15 dagen, bijna altijd na een publicatie van een derde partij. Het speciale dossier van Gondola vertelt het verhaal van de sector; dit artikel vertaalt het naar lessen voor elk merk.
Het volledige rapport is gratis beschikbaar: Sectorrapport.
Op 6 oktober 2026 publiceert een ngo de Superlist, de rangschikking van Belgische supermarkten op hun milieuprestaties. Binnen 72 uur hebben ChatGPT, Google AI Overview en Google AI Mode ze alle drie overgenomen, in beide landstalen. Lidl wordt de duurzaamheidsreferentie van de engines. Aldi erft de laatste plaats. Geen van beide ketens had zelf iets gepubliceerd.
We weten dat omdat we keken, elke dag, vraag per vraag. Wat ik in individuele AI-reputatieaudits observeer, hebben we hier op het niveau van een hele sector gemeten, voor een mediapartner die de Belgische retail beter kent dan wie ook: Gondola.
Waarom Gondola AI-antwoorden op de cover zet
Gondola wijdt een speciaal dossier aan deze audit: de eerste sectorbrede momentopname van wat AI-engines Belgische consumenten vertellen over hun supermarkten. De vraag erachter is die elke retail-CEO zich zou moeten stellen. Wanneer een consument een AI vraagt welke keten vertrouwen verdient, welke klantenkaart teleurstelt, waar promoties echte koopjes zijn: wie beveelt de engine aan, en op basis waarvan?
Het protocol, opgezet door PingPrime: 31 consumentenvragen over klantentrouw, prijzen, versheid, personeel, duurzaamheid en meer, elke dag gesteld van 25 september tot 9 oktober 2026, in gespiegelde Franse en Nederlandse versies, aan drie engines: ChatGPT, Google AI Overview en Google AI Mode. Het corpus: 2.790 AI-antwoorden en 15.368 geciteerde links, zonder één ontbrekende dag (PingPrime × Gondola, 2026).
Een methodologische kanttekening, want die telt: de vaststellingen hieronder, positief of kritisch, zijn wat de engines tijdens dat venster antwoordden. Het zijn hún lezingen, geen oordeel van PingPrime, en evenmin van Gondola. En 15 dagen geven een betrouwbare trend op deze steekproef weer, geen representatieve peiling.
De Delhaize-paradox: bekend zijn is geen netto troef
Delhaize is de keten waarover de engines het meest spreken: genoemd in 89% van de Franstalige en 84% van de Nederlandstalige antwoorden (PingPrime × Gondola, 2026). Het is ook de meest betwiste. Vraag na vraag keren dezelfde kritieken terug, tot ze een samenhangend tegenverhaal vormen, dat van vraag tot vraag terugkeert: de SuperPlus-klantenkaart is de eerste kaart die de engines als teleurstellend noemen, in beide talen, aangevuld met frictie aan de zelfscan aan Franstalige kant en met het prijsimago aan Nederlandstalige kant.
En toch pakt diezelfde Delhaize de eerste plaats van de engines op brood en op wijn, en deelt ze de eerste plaats op versheid in het Nederlands. Beide verhalen zijn tegelijk waar. Precies daar zit het punt: op dit niveau van zichtbaarheid is de vraag niet langer "praat men over ons?" maar "welk verhaal vertelt men?". Bekendheid is geen bezit; het is een verhaal dat iemand schrijft. De audit toont wie.
Aanbeveling heeft haar eigen logica: de casus Colruyt
Het dossier van Gondola noemt ze "positieve verdicten", en de audit telt zorgvuldig twee niveaus apart. De expliciete aanbeveling: de engine noemt een keten als een goede keuze, en één antwoord kan er meerdere bevatten. Het verdict: de eerste plaats, de keten die wordt aangewezen als DÉ keuze voor een vraag of een domein. Een merk kan aanbevelingen opstapelen zonder ooit een verdict te halen. Op wijn in het Frans wordt Colruyt aanbevolen, maar het verdict gaat naar Delhaize.
Op aanbevelingen domineert Colruyt beide talen, cumulatief over de periode, met 27 expliciete aanbevelingen in het Frans en 21 in het Nederlands, gedragen door onder meer prijs, promoties, vertrouwen, personeel en vlees (PingPrime × Gondola, 2026). Lokale producenten, waar ze tegelijk wordt aanbevolen en bekritiseerd, zijn een domein met twee gezichten.
Op productkwaliteit is het beeld genuanceerder. Versheid en bakkerij: het merk Colruyt zelf haalt de eerste plaats niet; die verdicten gaan naar Bio-Planet (versheid, aan Franstalige kant) en CRU (bakkerij, aan Nederlandstalige kant, bij één engine), de gespecialiseerde ketens van de groep, naast Delhaize en Lidl. Wijn: aanbevolen op de tweede plaats na Delhaize aan Franstalige kant, en een gedeelde eerste plaats met Delhaize aan Nederlandstalige kant. Vlees: eerste in beide talen, onder het eigen merk.
Voor AI-engines draagt elke keten haar eigen autoriteit: een architectuur met meerdere ketens versnippert het reputatiekapitaal van de groep.
Het scherpste bewijs dat zichtbaarheid geen aanbeveling koopt, zit in één vergelijking. Bio-Planet komt in slechts 27% van de Franstalige antwoorden voor en haalt 14 expliciete aanbevelingen. Carrefour komt in 82% voor en haalt er 12. Een smal domein met duidelijke bewijzen wint van aanwezigheid op alle fronten. De engines redeneren in vergelijkende landschappen, met gemiddeld vijf ketens per antwoord, en ze belonen het merk dat in dat landschap een duidelijke eigen rol speelt.
Wie schrijft echt de AI-reputatie van de sector: een tiental bronnen
De sites van de ketens worden massaal geciteerd in het corpus, maar meestal voor feiten en bewijzen: adressen, promoties, assortiment. Zodra een vraag om een oordeel vraagt, schakelen de engines over naar derden. En die laag van derden is opvallend geconcentreerd: per markt worden zo'n 500 domeinen geciteerd, maar de top 10 alleen al is goed voor ongeveer 40% van alle citaties (PingPrime × Gondola, 2026).
De twee talen hebben twee bewijsculturen. Aan Franstalige kant is de eerste bron de consumentenvergelijker test-achats.be (8,6% van alle citaties op zichzelf), en drie van de top tien zijn communityplatformen: Facebook, YouTube, Reddit. Het oordeel vormt zich er via tests en ervaringen. Aan Nederlandstalige kant zijn vijf van de top tien nieuwsmedia, met hln.be op kop (7,4%): het verhaal loopt via de pers, ook de landbouwpers, wat het boerenverhaal in Vlaanderen structureel maakt, niet episodisch.
Dit is de gekwantificeerde versie van wat wij noemen: aan beide kanten van het signaal werken. On-site, omdat één goed gebouwde pagina een volledig domein in de antwoorden kan dragen. Off-site, omdat goed behandeld worden door tien spilbronnen zwaarder weegt dan zichtbaar zijn op honderd sites.
Lees die zin aandachtig, want hij gaat niet alleen over volume. De engines houden van herhaling: een verhaal wint aan gewicht wanneer onafhankelijke bronnen het herhalen. Maar herhaling alleen beslist niet; vertrouwen, autoriteit en coherentie wel. Drie eigenschappen bepalen het gewicht van een bron in een AI-antwoord. Haar autoriteit: wie spreekt er, en beschouwt de engine haar al als een referentie voor de categorie? De coherentie van het verhaal: beschrijven onafhankelijke bronnen u in dezelfde termen, of vertelt elk een net iets andere versie? En de leesbaarheid van het bewijs: kan de engine er zonder frictie een helder, toewijsbaar feit uit halen? Tien betrouwbare bronnen die elkaar bevestigen, bouwen een positie op. Honderd verspreide vermeldingen die uiteenlopen, verdunnen ze.
Lidl is er het levende bewijs van: haar posities op vertrouwen, versheid en duurzaamheid in het Nederlands worden gedragen door YouGov, het Versrapport en de Superlist, drie onafhankelijke referenties die de engines al als autoriteit behandelen, en niet door lidl.be.
Vijftien dagen, 38 kantelingen: AI-reputatie is een stroom
Dit is misschien het belangrijkste resultaat van het dossier. Van de 186 engine-lezingen die we tussen 25 september en 9 oktober 2026 volgden, veranderden er 38 van positie: een nieuwe keten bovenaan, of een toon die omslaat. Eén op vijf (PingPrime × Gondola, 2026). De trigger is bijna altijd dezelfde: een vers geïndexeerde publicatie van een derde partij.
De verhalen achter de cijfers zijn het vertellen waard:
- De Superlist, 72 uur. Het duurzaamheidsgesprek bleef vaag tot 6 oktober. Daarna namen de drie engines de rangschikking van de ngo in drie dagen over, in beide talen. Lidl eerste, Aldi laatste.
- Het herstel van Carrefour aan de zelfscan. Van "slechte leerling" op frictie aan de kassa naar aanbeveling nummer één op Google AI Overview in het Nederlands, in ongeveer een week. Een domein vol ergernissen kan in enkele dagen kantelen.
- De slechte leerling wisselt. De keten die met de vinger werd gewezen voor prijsstijgingen, veranderde twee keer tijdens het venster, op het ritme van de geïndexeerde prijsmetingen: eerst Colruyt, dan Carrefour en de buurtformules, dan Albert Heijn.
- De AI-sommelier. Colruyt lanceert op 1 oktober een wijnadviseur op basis van AI; Google AI Mode citeert hem vanaf de lancering in de Nederlandstalige wijnantwoorden. Een van de zeldzame kantelingen die vermoedelijk werd uitgelokt door het nieuws van een keten zelf, en niet door een derde.
Voeg daar nog een laag instabiliteit aan toe: de engines zijn het onderling niet eens. Waar minstens twee engines een eerste keuze aanwijzen, zijn ze maar in 44% van de gevallen eensgezind, omdat elk zijn eigen bronnendieet heeft: ChatGPT leunt op e-commerce en vergelijkers, de tools van Google (AI Overview en AI Mode) op de pers. U kunt één engine winnen en de twee andere verliezen.
Zonder een kalender van verse bewijzen schrijven anderen uw verhaal.
Twee talen, twee gesprekken over hetzelfde land
Dezelfde 31 vragen, gesteld in het Frans en in het Nederlands, leveren niet hetzelfde verhaal op. Albert Heijn weegt 19 punten zwaarder in Nederlandstalig België; Carrefour 14 punten minder; Jumbo bestaat vrijwel alleen in Vlaanderen (PingPrime × Gondola, 2026). De oorzaak ligt stroomopwaarts: elke taal heeft haar eigen bronnenecosysteem, en slechts één medium staat in beide top 10's: retaildetail.be.
Voor elk merk dat in België actief is, is de implicatie ongemakkelijk maar werkbaar: u hebt niet één AI-reputatie, u hebt er één per taal, en die moeten apart gemeten en bewerkt worden.
Wat dit betekent voor uw merk, in elke sector
U hoeft geen supermarkt te zijn om deze mechanismen te herkennen. Vijf consequenties om mee aan de slag te gaan:
- Meet vermelding, citatie en aanbeveling apart. Delhaize leidt in vermeldingen, Colruyt in aanbevelingen, test-achats.be in citaties. Een dashboard dat alleen zichtbaarheid volgt, mist twee van de drie strijdtonelen.
- Identificeer uw tien spilbronnen, per taal. Welke domeinen voeden de AI-antwoorden over uw categorie, en wat zeggen ze vandaag over u? In deze sector past het antwoord op één slide, en het bepaalt de prioriteiten.
- Kies domeinen, installeer er bewijzen. Bio-Planet verslaat Carrefour in aanbevelingen met een derde van de aanwezigheid. De engines belonen een precieze claim met bewijs, geen ruis op alle fronten.
- Bereid de kritische invalshoeken voor. Op vragen die uitnodigen tot kritiek is 42 tot 54% van de lezingen negatief of gemengd, tegenover 3% op kwaliteitsvragen (PingPrime × Gondola, 2026). Weet welke invalshoeken u verliest, nog voor consumenten de vraag stellen.
- Volg continu op. Eén geïndexeerde publicatie herverdeelde verdicten in 72 uur. Een jaarlijkse audit fotografeert een rivier. Driemaandelijkse golven zijn het minimale ritme dat wij ernstig vinden.
Eén kanttekening, want nuance hoort bij de methode: dit werk vervangt SEO noch merkstrategie. Het dekt wat zij niet dekken: hoe generatieve engines u selecteren, beschrijven en aanbevelen, taal per taal, engine per engine.
FAQ
Wat is een AI-reputatieaudit?
Een AI-reputatieaudit meet hoe generatieve engines (ChatGPT, Google AI Overview, Google AI Mode en andere) een merk beschrijven, bekritiseren en aanbevelen: in welke vragen het verschijnt, hoe het wordt voorgesteld, en welke bronnen die antwoorden voeden. Hij verschilt van social listening omdat hij de antwoorden en citaties van de engines zelf analyseert, niet de publieke conversaties.
Wat staat er in het speciale dossier van Gondola?
Het dossier van Gondola presenteert de sectorresultaten van de PingPrime-audit: welke Belgische ketens de engines noemen, citeren en aanbevelen, de "positieve verdicten" per domein (prijs, versheid, personeel, duurzaamheid en meer), en hoe de antwoorden verschoven tijdens het observatievenster van 15 dagen (25 september tot 9 oktober 2026), in het Frans en in het Nederlands.
Waarom veranderen AI-antwoorden over merken zo vaak?
Omdat de engines in real time verifiëren en voortdurend verse bronnen opnemen. In deze audit veranderde één gevolgde lezing op vijf van positie in 15 dagen, bijna altijd na de indexering van een publicatie van een derde: de duurzaamheidsrangschikking Superlist herverdeelde de verdicten van de drie engines in 72 uur.
Garandeert bekendheid dat AI-engines u aanbevelen?
Nee. Delhaize wordt in 89% van de Franstalige antwoorden genoemd, maar draagt het zwaarste tegenverhaal van de sector, terwijl Bio-Planet, aanwezig in 27% van de antwoorden, meer expliciete aanbevelingen haalt dan Carrefour, aanwezig in 82%. De engines belonen een helder verhaal op een precies domein, geen ruwe zichtbaarheid.
Hoe kan een merk verbeteren hoe AI-engines het beschrijven?
Door aan beide kanten van het signaal te werken. On-site: gestructureerde, educatieve pagina's die klaar zijn voor extractie, waaruit de engines bewijzen kunnen halen. Off-site: een bewuste aanwezigheid in de spilbronnen die de engines voor uw categorie citeren, per taal en per engine. En dan meten in doorlopende golven, want posities verschuiven elke week.
Bronnen
- Gondola, speciaal dossier over de AI-reputatie van Belgische supermarkten, op basis van de PingPrime-audit, november 2026.
- PingPrime × Gondola, "Que disent les IA des supermarchés belges ?", AI-reputatieaudit, sectorrapport, Belgische voedingsretail, november 2026. Verzamelvenster: 25/09 tot 09/10/2026, 2.790 AI-antwoorden, 15.368 geciteerde links. Sectorrapport
Alle cijfers in dit artikel komen uit de PingPrime × Gondola-audit. Citeren is toegestaan met de vermelding "PingPrime × Gondola". De vaststellingen, positief of kritisch, geven weer wat de AI-engines tijdens het observatievenster antwoordden: ze drukken geen oordeel uit van PingPrime, noch van Gondola, over de genoemde ketens.
Onderwerp, invalshoek, overtuigingen: de mijne. AI helpt bij het schrijven. Ik beslis.
Sabrina Bulteau is medeoprichter van PingPrime.ai, GEO-expert en specialist in Narrative Authority in AI Search. Ze helpt merken, instellingen en media de referentie te worden die generatieve engines citeren, vertrouwen en herhalen. Eerder was ze medeoprichter van Be Connect (overgenomen door iO Group) en Sench, ze is actief binnen CEC Belgium en heeft 25 jaar ervaring in digitale groei en strategische positionering.