
Nummer 1 Zijn Maakt Nauwelijks Uit in ChatGPT. Hier Is de Wiskunde.


TL;DR
- ChatGPT voert niet jouw vraag uit. Het voert zijn eigen vragen uit. Eén prompt waaiert uit naar gemiddeld ongeveer negen onzichtbare subquery's (Nectiv, 60.000+ geanalyseerde fan-outs, 2026), en tot 28 op Gemini 3 (Seer Interactive, 501 prompts, 2026).
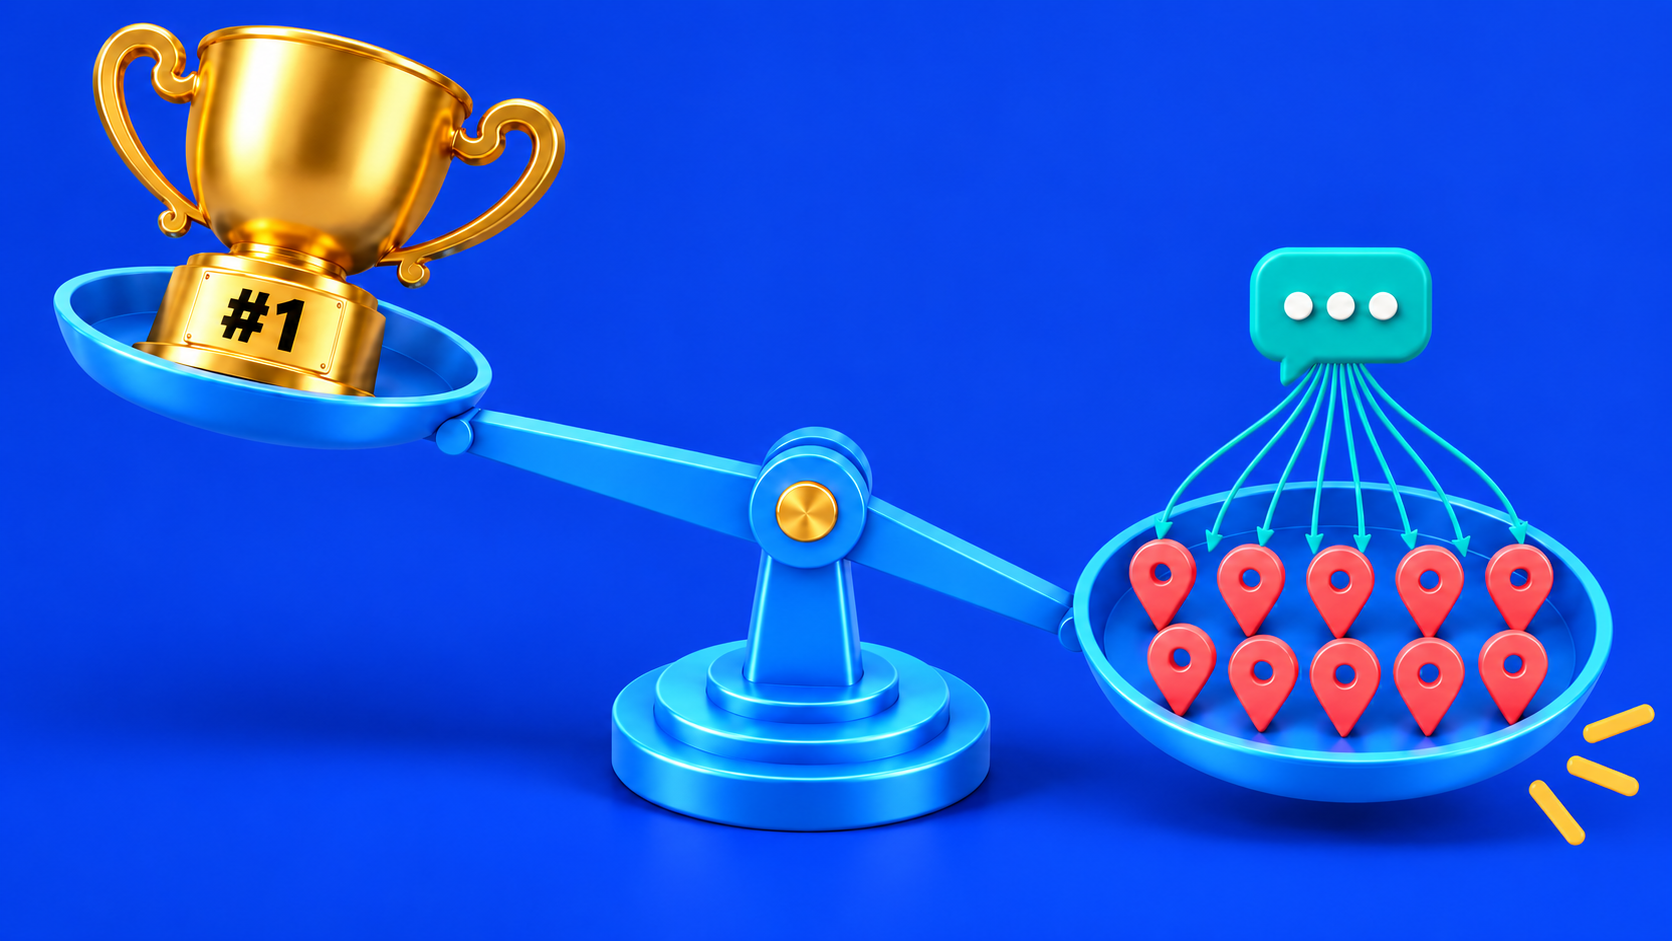
- De resultaten worden samengevoegd met Reciprocal Rank Fusion (RRF): een algoritme geïdentificeerd in ChatGPT's citatie-ranking door onderzoeker Metehan Yesilyurt (juli 2025). De wiskunde: een middenmoot-aanwezigheid over tien gerelateerde subquery's kan zwaarder wegen dan een enkele #1, met ongeveer een factor acht.
- Nog opvallender: de engines schrijven nu merknamen in hun eigen zoekopdrachten. ChatGPT 5.5's fan-outs bevatten steeds vaker rechtstreeks merken (Seer Interactive, 617 prompts, 2026). Wanneer dat gebeurt, concurreer je niet langer binnen het antwoord: je bent waarnaar gezocht wordt.
- Dat is narratieve autoriteit in haar meest letterlijke, meetbare vorm: voldoende aanwezig zijn over externe bronnen zodat de engine je uit zichzelf oproept.
Wat gebeurt er echt tussen jouw vraag en ChatGPT's antwoord?
Een zoekopdracht die je nooit ziet. Wanneer een gebruiker een generatieve engine een vraag stelt ("beste projectmanagementtools", "welk bureau voor AI-zoeken") voert het model die query niet uit zoals getypt. Het herschrijft ze in een bundel subquery's die de hoeken bestrijkt die het relevant acht: vergelijkingen, reviews, prijzen, specifieke merknamen, het huidige jaar. Het voert ze parallel uit, verzamelt de gerangschikte resultaten van elk, en versmelt alles tot het ene antwoord dat de gebruiker leest. Die achtergrondzoekopdrachten zijn de fan-out queries.
De gemeten omvang van deze verborgen laag:
Twee eigenschappen maken deze laag strategisch onzichtbaar voor klassieke SEO. De queries zijn door de machine geschreven tijdens runtime (in steno die geen mens typt ("Pipedrive pricing 2026 plans")), dus ongeveer 95% ervan heeft nul volume in elke keyword-tool. En ze zijn onstabiel: Seer Interactive mat slechts 0,1% overlap in fan-outs tussen runs van dezelfde prompt op Gemini 3. Je keyword-tracker kan letterlijk de zoekopdrachten niet zien die je AI-zichtbaarheid bepalen.
Wat is Reciprocal Rank Fusion, en waarom onttroont het #1?
RRF is de samenvoegstap, en ze verandert wat "winnen" betekent. In juli 2025 inspecteerde GEO-onderzoeker Metehan Yesilyurt (Peec AI) ChatGPT's code en identificeerde Reciprocal Rank Fusion als het algoritme dat resultaten over subquery's samenvoegt. RRF zelf is niet nieuw: het is gedocumenteerd in information-retrieval-literatuur sinds 2009. De bevinding was dat het binnen ChatGPT draait.
De formule is ontwapenend eenvoudig. Voor elke fan-out query waarin je pagina verschijnt, verdient ze:
score = 1 / (k + rang), met k ≈ 60. De scores worden dan opgeteld over alle subquery's.
Reken het nu na:
- Een enkele #1-ranking op één query: 1 / (60 + 1) = 0,0164
- Rang ~20 over tien gerelateerde subquery's: 10 × 1 / (60 + 20) = 0,125, ongeveer 8x meer
- Rang ~5 over tien subquery's: 10 × 1 / (60 + 5) = 0,154, bijna 10x meer
Omdat k = 60 het verschil tussen posities dempt, is het verschil tussen rang 1 en rang 20 binnen één query klein, terwijl elke extra query waarin je verschijnt een volledige nieuwe term aan je som toevoegt. De conclusie is wiskundig, niet retorisch: uitmuntendheid op één hoek verliest van aanwezigheid op alle hoeken. De correlatiedata bevestigt dit: pagina's gedekt door fan-out queries hadden 161% meer kans om geciteerd te worden, met een correlatie van 0,77 tussen fan-out-dekking en AI Overview-citaties (Surfer SEO, 2026).
Provocerend? Nee. Het is rekenkunde.
De meer verontrustende bevinding: merken binnen de fan-outs zelf
De engines zijn merknamen in hun eigen zoekopdrachten beginnen schrijven. Seer Interactive's onderzoek naar ChatGPT 5.5 (Wil Reynolds en Nick Haigler, 617 prompts die vragen dekken die een CMO of VP Growth zou stellen, juni 2026) documenteert die verschuiving: waar fan-outs vroeger "top GEO-bureaus" lazen, lezen ze steeds vaker "[specifiek bureau] GEO-onderzoek". De generieke categoriequery maakt plaats voor spontaan door het model gegenereerde named-entity queries: merken die nooit in de prompt van de gebruiker stonden.
Op Gemini 3 mat Seer het rechtstreeks: 26,4% van de fan-out queries bevatte een merknaam (501 prompts, 2026). En toen Seer een enkele bureau-selectieprompt 30 keer opnieuw draaide op ChatGPT 5.5, verscheen één bedrijf (iPullRank) 97% van de tijd in de fan-outs, en zijn oprichter Mike King 63% van de tijd. Jaren van het publiceren van een consistent, herkenbaar standpunt hadden die entiteit vastgeklonken aan dat onderwerp in het hoofd van het model.
Lees traag wat dat betekent.
Wanneer je merk binnen de fan-out zit, ben je niet langer één kandidaat die binnen het antwoord concurreert. Jij bent de zoekopdracht. De engine heeft al beslist dat je tot deze categorie behoort: het zoekt nu materiaal over jou om zijn antwoord op te bouwen.
Je zit niet in het resultaat. Je bent het resultaat.
Dit is precies wat we bedoelen met narratieve autoriteit, in haar meest letterlijke, meetbare vorm: voldoende aanwezig zijn, consistent genoeg, over externe bronnen, zodat de engine je spontaan oproept. Niet omdat je rankte. Omdat je vastgeklonken bent. Het is hetzelfde mechanisme dat we van de kopers-kant zagen in onze analyse van de Semrush B2B-data: modellen leren categoriale lidmaatschap uit co-occurrence over onafhankelijke bronnen (reviews, uitgevers, expertdekking), niet uit wat een merk over zichzelf zegt.
SEO optimaliseert wat je ziet. GEO speelt zich af waar je niet kijkt.
Laten we precies zijn, want de nuance is de expertise. Fan-out queries zijn nog steeds zoekopdrachten. Ze raken nog steeds indexen waar structuur, crawlbaarheid en rankingfundamenten beslissen wie naar boven komt, daarom blijft de SEO-basis noodzakelijk. Goed ranken voedt de fan-outs. Het is simpelweg niet langer voldoende, omdat de concurrentie-eenheid is veranderd:
- SEO optimaliseert de ene query die je ziet: het sterkeyword in je tracker, met zijn volume en zijn positie.
- GEO speelt zich af over de tien of twintig queries die je niet ziet: machinaal geschreven, nul volume, onstabiel tussen runs, en samengevoegd door een algoritme dat breedte en herhaling boven een enkele piek beloont.
Het patroon dat ik in de meeste GEO-diagnoses vind, is precies deze blinde vlek: merken die jaren hebben besteed aan het perfectioneren van hun sterquery, en de andere hoeken negeren die engines echt doorzoeken. Een patroon dat onze eigen monitoring blijft bevestigen: over de vragen die we dagelijks volgen op ChatGPT, Google AI Mode en AI Overviews, variëren de geciteerde bronnen sterk van run tot run en van hoek tot hoek: de merken die standhouden doorheen die volatiliteit zijn die aanwezig op veel hoeken via veel onafhankelijke bronnen, nooit die met één perfect geoptimaliseerde pagina.
Hoe dek je de queries die je negeert?
Drie zetten, in volgorde, en beide kanten van het signaal.
- Breng de fan-outs van je categorie in kaart. Vang wat de engines echt doorzoeken wanneer de vragen van je kopers binnenkomen: de vergelijkingen, de "vs"-queries, de prijshoeken, de jaargebonden varianten, de aanpalende how-to's. Verschillende tools tonen fan-outs nu rechtstreeks. Dit is je echte keyworduniversum: dat met nul zoekvolume en alle invloed.
- Bouw dekking, geen heldenpagina. Eén definitieve pagina per hoek verslaat één uitputtende pagina voor de hoofdterm. Onder RRF weegt een topiccluster dat middenmoot verschijnt over tien subquery's wiskundig zwaarder dan een enkele #1. Structureer elke pagina zodat ze extraheerbaar is: zelfstandige secties, claims vooraan. 44,2% van de LLM-citaties komt uit de eerste 30% van content (Growth Memo, februari 2026).
- Laat je via derden in de fan-outs schrijven. Het merk-in-fan-out-effect wordt niet getriggerd door je eigen site. Het wordt getriggerd door co-occurrence: je naam die herhaaldelijk naast je categorie verschijnt, over onafhankelijke bronnen heen. Dat is off-site autoriteitsopbouw: reviews, sectorpers, expertcitaten, vergelijkingen die je noemen tussen je peers. 85% van de merkvermeldingen in AI-antwoorden komt al van externe bronnen (AirOps, 2025); de fan-out-data toont dat diezelfde bronnen het model leren om jou op naam te zoeken.
Eén voorbehoud, omdat geloofwaardigheid het vereist: fan-out-gedrag verschilt per engine (Gemini 3 draait ongeveer vijf keer meer subquery's dan ChatGPT (Seer Interactive, 2026)) en deze mechanismen zijn reverse-engineered observaties van bewegende systemen, geen gepubliceerde specificaties. Behandel de cijfers als solide ordes van grootte, herzie ze elk kwartaal, en bouw nooit een strategie op de eigenaardigheden van één engine. Het principe blijft echter stabiel over alle heen: fusie beloont aanwezigheid over hoeken.
De vraag die er echt toe doet
Elke keer dat iemand een AI-engine een vraag stelt over jouw categorie (het moment dat we lokaliseerden in het nieuwe adres van de aankoopbeslissing), schrijft de engine zijn dozijn zoekopdrachten en versmelt de resultaten. Dat proces draait of je eraan deelneemt of niet.
De echte vraag is dus niet langer "staan we op #1?"
Het is: wanneer jouw categorie zijn fan-outs genereert, zit jij erin?
FAQ
Wat is een query fan-out in AI-zoeken?
De set extra zoekopdrachten die een AI-engine onzichtbaar uitvoert na één gebruikersprompt: het model herschrijft de vraag in meerdere subquery's, voert ze parallel uit, en synthetiseert één antwoord uit de samengevoegde resultaten. Gemiddelden: ~9 per ChatGPT-prompt (Nectiv, 2026), 10,7 op Gemini 3 met pieken tot 28 (Seer Interactive, 2026). Ongeveer 95% heeft nul zoekvolume.
Wat is Reciprocal Rank Fusion (RRF)?
Een rankingalgoritme uit information-retrieval-onderzoek (gedocumenteerd sinds 2009) dat resultatenlijsten van meerdere queries samenvoegt door elke pagina 1/(k + rang) te scoren, met k ≈ 60, opgeteld over queries. Metehan Yesilyurt identificeerde het in ChatGPT's citatie-ranking in juli 2025.
Waarom maakt #1 ranken minder uit in ChatGPT dan in Google?
Omdat het antwoord wordt samengevoegd uit veel subquery's. Een enkele #1 scoort 1/61 ≈ 0,0164 onder RRF; een rang-20-aanwezigheid over tien subquery's scoort 0,125, ongeveer acht keer meer. Breedte over de hoeken die de engine doorzoekt verslaat een enkele zichtbare piek.
Hoe raakt een merk geschreven in AI fan-out queries?
Via categorie-co-occurrence opgebouwd off-site: herhaalde, consistente externe aanwezigheid (reviews, expertdekking, vergelijkingen die je noemen tussen je peers) leert het model dat jouw entiteit tot de categorie behoort. Seer Interactive vond dat 26,4% van Gemini 3's fan-outs een merknaam bevat, en één consistent publicerend bedrijf verscheen 97% van de tijd in ChatGPT 5.5's fan-outs over 30 runs van dezelfde prompt (2026).
------
HOE DIT ARTIKEL IS GESCHREVEN: Onderwerp, invalshoek, overtuigingen: van mij. AI helpt bij het schrijven. Ik beslis.
Sabrina Bulteau is de medeoprichtster van PingPrime.ai, GEO-expert en specialist in Narrative Authority in AI-zoeken. Ze helpt merken, instellingen en media de referentie te worden die AI-engines vertrouwen, citeren en herhalen (niet zomaar één optie tussen vele) door aan beide kanten van het signaal te werken: on-site (structuur, narratieven, architectuur) en off-site (verdiende media, platformen, co-citaties, sectorpers). Mede-oprichtster van Be Connect (overgenomen door iO Group) en Sench, actief binnen CEC Belgium, brengt ze 25 jaar ervaring mee in digitale groei en strategische positionering.

